Chuyên mục "Mô hình SEM"

Hiển thị các bài đăng có nhãn Mô hình SEM. Hiển thị tất cả bài đăng

Hướng dẫn giải thích và đọc kết quả phân tích EFA trên Stata


Tiếp tục bài giới thiệu về nhân tố khám phá EFA, bài viết này sẽ minh họa các bước thực hiện và giải thích các kết quả phân tích nhân tố khám phá trên phần mềm Stata. Kết quả phân tích nhân tố sẽ được thực hiện với phép trích nhân tố mặc định là pf với 2 phép xoay varimax và promax.

Bài viết sử dụng dữ liệu thực hành là efa.dta. Bộ dữ liệu bao gồm 9 biến quan sát (x1-x9) và 3 biến đánh giá (y1 – y3). Các biến đều có thang đo Likert – 5 bậc. Bộ dữ liệu được khảo sát nhằm đánh giá chất lượng giảng dạy của người giảng viên ở 2 khía cạnh uy tín – kiến thức và kỹ năng truyền đạt. Chi tiết: https://vietlod.com/nhan-to-kham-pha-stata

Phân tích hệ số tin cậy Cronbach alpha trên Stata


Hệ số tin cậy Cronbach anpha được sử dụng để kiểm tra độ tin cậy bên trong của thang đo. Nó cho biết mức độ tương quan giữa các biến trong mỗi nhóm (nhân tố). Giá trị của hệ số tin cậy anpha cao của phương pháp không có nghĩa tính chất nhất quán của thang đo đã được thỏa mãn. Chúng ta cần phải sử dụng các kỹ thuật phân tích khác, chẳng hạn, phân tích nhân tố khẳng định CFA để kiểm định tính nhất quán này. Bài viết sẽ minh họa cách thực hiện phân tích hệ số tin cậy Cronbach anpha, cùng với việc giải thích các thông số của kết quả trên phần mềm Stata. Chi tiết: https://vietlod.com/he-so-tin-cay-cronbach-anpha-stata

Kết quả phân tích nhân tố khám phá trên Stata ở bài trước cho thấy chất lượng đội ngũ giảng viên có thể được đánh giá qua 2 nhân tố là uy tín – kiến thức và kỹ năng truyền đạt. Trong đó, nhân tố uy tín – kiến thức được tổng hợp từ 5 biến x1 – x5 và nhân tố kỹ năng truyền đạt được tổng hợp bởi 4 biến quan sát x6 – x9.

Hướng dẫn thực hiện phân tích nhân tố khám phá EFA trên Stata


Phân tích nhân tố khám phá EFA (Exploratory factor analysis) là một phương pháp rút gọn dữ liệu, cho biết mối quan hệ giữa các nhóm biến quan sát với các biến ẩn được gọi là các nhân tố. Sự kết hợp giữa phân tích nhân tố khám phá và phân tích nhân tố khẳng định sẽ tạo ra một bộ nhân tố đảm bảo độ tin cậy và hiệu quả cao.

Bài viết này sẽ tóm tắt lý thuyết phân tích nhân tố khám phá trên phần mềm Stata với câu lệnh factor. Phần trình bày phương pháp phân tích nhân tố khẳng định kết hợp với phân tích nhân tố khám phá sẽ được trình bày ở bài viết phân tích nhân tố khẳng định CFA. Chi tiết: https://vietlod.com/nhan-to-kham-pha-efa

Giới thiệu phép xoay nhân tố trong phân tích EFA


Một trong các bước quan trọng của phân tích nhân tố khám phá cũng như phân tích thành phần chính (PCA) là lựa chọn một phép xoay nhân tố hoặc thành phần (gọi tắt là phép xoay nhân tố). Bài viết này sẽ trình bày một số vấn đề liên quan đến phép xoay nhân tố. Qua bài viết này các bạn có thể biết thêm về ý nghĩa của các phép xoay và lựa chọn một phép xoay phù hợp cho nghiên cứu của mình. Chi tiết: https://vietlod.com/phep-xoay-nhan-to

Phân biệt PCA và EFA trong phân tích nhân tố


Phân tích thành phần chính (PCA) và phân tích nhân tố khám phá (EFA) là 2 phương pháp được sử dụng phổ biến trong các nghiên cứu thị trường. Cả hai phương pháp PCA vs EFA đều có cách thực hiện tương đối giống nhau. Tuy nhiên, mỗi phương pháp đều có mục tiêu riêng và sự phân biệt giữa 2 phương pháp PCA vs EFA vẫn còn rất nhiều điểm mơ hồ. Bài viết này thể hiện một số quan điểm của tác giả nhằm phân biệt PCA vs EFA. Đầu tiên là sự giống nhau giữa PCA vs EFA. Chi tiết: https://vietlod.com/phan-biet-pca-vs-efa

Hướng dẫn đọc kết quả phân tích CATPCA trên SPSS


Phân tích CATPCA hay còn gọi là phân tích thành phần chính dạng danh mục CATPCA (Categorical principal components analysis) là được sử dụng tinh giản dữ liệu khi các biến có dạng phân loại, với mục tiêu là xác định các thành phần chính của một tập biến có khả năng giải thích (đại diện) tốt nhất cho dữ liệu.

Tiếp tục phần trình bày ở bài minh họa thực hiện phân tích CATPCA trên SPSS, bài viết này sẽ đi sâu diễn giải kết quả phân tích CATPCA. Đầu tiên là phần giới thiệu về phiên bản của CATPCA, tiếp đến là thông tin thống kê sơ bộ về mô hình phân tích. Chi tiết: https://vietlod.com/doc-ket-qua-phan-tich-catpca-spss

Hướng dẫn thực hiện phân tích CATPCA trên SPSS


Phân tích CATPCA hay còn gọi là phân tích thành phần chính dạng danh mục CATPCA (Categorical principal components analysis) là được sử dụng tinh giản dữ liệu khi dữ liệu các biến có dạng phân loại, với mục tiêu là xác định các thành phần chính của một tập biến có khả năng giải thích (đại diện) tốt nhất cho dữ liệu. Chi tiết: https://vietlod.com/phan-tich-catpca-spss

Phương pháp phân tách (Discriminant analysis) là một phương pháp phân tích thống kê được dùng rất nhiều trong Data mining để phân loại các đối tượng (object) vào các nhóm dựa việc đo lường các đặc trưng của đối tượng. Chi tiết: https://vietlod.com/phuong-phap-phan-tach-discriminant-analysis


Không giống như phân tích cluster không đòi hỏi biết trước số nhóm và các đối tượng ở mỗi nhóm, phương pháp phân tách đòi hỏi phải biết trước số nhóm và các đối tượng trong mỗi nhóm trước khi tiến hành phân tích. Điều này có nghĩa, trong thiết kế nghiên cứu phương pháp phân tách người nghiên cứu phải xác định trước đặc điểm của các nhóm và tiến hành thu thập dữ liệu (đối tượng) cho mỗi nhóm.

Mục đích chính của phương pháp phân tách là:
- Tìm tập hợp những thuộc tính tốt nhất để mô tả đối tượng hay trích lọc thuộc tính (feature extraction) và trích chọn mẫu (sapmple extraction) nhằm làm giảm số chiều biểu diễn đối tượng;
- Tìm một mô hình tốt nhất để phân nhóm các đối tượng.

Ngược lại với phân tích cluster thứ bậc, phương pháp phân tích cluster không thứ bậc (Non Hierarchical Cluster Analysis) không bao gồm quy trình phân nhóm hình cây mà thay vào đó là phân bổ các đối tượng vào số lượng các cluster đã xác định trước.


Phân tích cluster không thứ bậc bao gồm 3 phương pháp chủ yếu là: (i) phương pháp ngưỡng tuần tự (Sequential threshold); (ii) phương pháp ngưỡng song song (Parallel threshold); (iii) phương pháp phân chia tối ưu (Optimizing partitioning). Các phương pháp này còn được gọi chung là phương pháp K-Means.

Chi tiết: https://vietlod.com/phuong-phap-k-means-spss

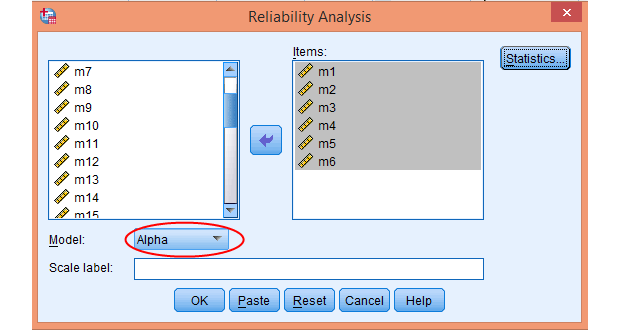
Hệ số Cronbach anpha là một hệ số kiểm định thống kê về mức độ tin cậy và tương quan trong giữa các biến quan sát trong thang đo. Tư tưởng chung của phương pháp này là tìm kiếm sự vô lý nếu có trong các câu trả lời (hay có nên đưa một biến quan sát vào một nhân tố hay không?). Nó cho biết sự chặt chẽ và thống nhất trong các câu trả lời nhằm đảm bảo người được hỏi đã hiểu cùng một khái niệm.
Chi tiết: https://vietlod.com/he-so-tin-cay-cronbach-anpha-spss


Phân tích nhân tố khám phá (EFA) là một trong những phương pháp phân tích thống kê dùng để rút gọn một tập hợp nhiều biến quan sát phụ thuộc lẫn nhau thành một tập biến ít hơn để chúng có ý nghĩa hơn nhưng vẫn chứa đựng hầu hết thông tin của tập biến ban đầu (Hair và cộng sự, 1998). Về nguyên tắc, EFA sẽ mô hình hóa cấu trúc phương sai của một tập biến quan sát bằng cách sử dụng kết hợp tuyến tính của các biến quan sát.


Những kết hợp tuyến tính này được gọi là các nhân tố (factors) có thể được sử dụng cho các phân tích tiếp theo. Các hệ số kết hợp được gọi là các hệ số tải (loadings) cho biết mức độ giải thích của nhân tố đối với các biến quan sát tương ứng. Ngày nay phân tích nhân tố khám phá được ứng dụng phổ biến trong các nghiên cứu Marketing, lĩnh vực quản trị hoặc các nghiên cứu khoa học của sinh viên.
Chi tiết: https://vietlod.com/nhan-to-kham-pha-spss

Một mô hình phương trình cấu trúc (mô hình SEM) điển hình, thông thường bao gồm các thành phần chính như sau:

  • Regression model
  • Path model
  • Factor (EFA, CFA) model
  • Structural model

3 thành phần đầu tiên (regression, path và factor) được gọi chung là mô hình đo lường. Mô hình SEM là sự kết hợp của mô hình đo lường (measurement model) và mô hình cấu trúc (structural model). Bài viết sau sẽ lần lượt giải thích từng thành phần của mô hình SEM. Đồng thời, bài viết sẽ trình bày 3 trường hợp xây dựng mô hình SEM, đó là mô hình kiểm chứng (strictly confirmatory - SC), mô hình thay thế (alternative models - AM), và mô hình tùy biến (model generating - MG).
http://vietlod.com/regression-path-analysis-efa-cfa-trong-mo-hinh-sem

Các phương pháp ANOVA, hồi quy tuyến tính đa biến, ANCOVA, MANOVA trong phương pháp hồi quy tuyến tính tổng quát (GLM) được xem là 1 trường hợp giới hạn của mô hình SEM (Fan, 1997). Vậy mô hình SEM là gì? Vì sao mô hình SEM cho phép thực hiện các phân tích linh hoạt hơn GLM và ngày càng được áp dụng phổ biến trong các nghiên cứu khoa học & thực nghiệm? Mặc dù rất nhiều tài liệu tiếng anh viết về vấn đề này, tuy nhiên, tại Việt Nam các lý thuyết về mô hình SEM là rất hạn chế.
Bài viết này sẽ lần lượt trình bày, phân biệt rõ ràng các khái niệm cơ bản của mô hình SEM như biến quan sát (observed variables hoặc manifest variables), chỉ báo (indicators), biến ẩn (latent variables), khái niệm (constructs) hoặc nhân tố (factors), cũng như phân biệt mô hình SEM với các mô hình/phương pháp thống kê truyền thống. Ngoài ra, bài viết còn đi sâu phân tích các đặc trưng cơ bản của mô hình SEM như yêu cầu cở mẫu lớn, ít tập trung vào các kiểm định thống kê riêng rẻ,… thông qua đó người đọc có thể biết được cách xác định cở mẫu tối ưu cho mô hình SEM, cũng như sử dụng các phép kiểm định thống kê phù hợp.
http://vietlod.com/gioi-thieu-ve-mo-hinh-sem

Nếu như kinh tế vĩ mô và kinh tế vi mô mô tả sự vận động của nền kinh tế thì kinh tế lượng cung cấp các phương pháp phân tích mổ xẻ mặt lượng quan hệ giữa các hiện tượng hoặc yếu tố kinh tế cùng sự tác động qua lại giữa chúng trên cơ sở các số liệu nhằm củng cố thêm giả thiết, từ đó đưa ra các quyết định đúng đắn hơn.

Kinh tế lượng từ nhiều năm đã được áp dụng rộng rãi trong nhiều ngành, không riêng gì kinh tế. Một số phương pháp, mô hình ước lượng thường được sử dụng trong nghiên cứu kinh tế

Ngoài ra, các bạn có thể tham khảo thêm các vấn đề về xử lý dữ liệu, lựa chọn kiểm định, thống kê mô tả và phân tích hồi quy từ cơ bản đến NÂNG CAO trên các phần mềm SPSS, STATA tại trang CÁC CHUYÊN ĐỀ KINH TẾ LƯỢNG

Author Name

Biểu mẫu liên hệ

Tên

Email *

Thông báo *

Được tạo bởi Blogger.